


ما هي البيانات الاصطناعية Synthetic Data؟ ولماذا يتدرب الذكاء الاصطناعي على بيانات لم يصنعها البشر؟

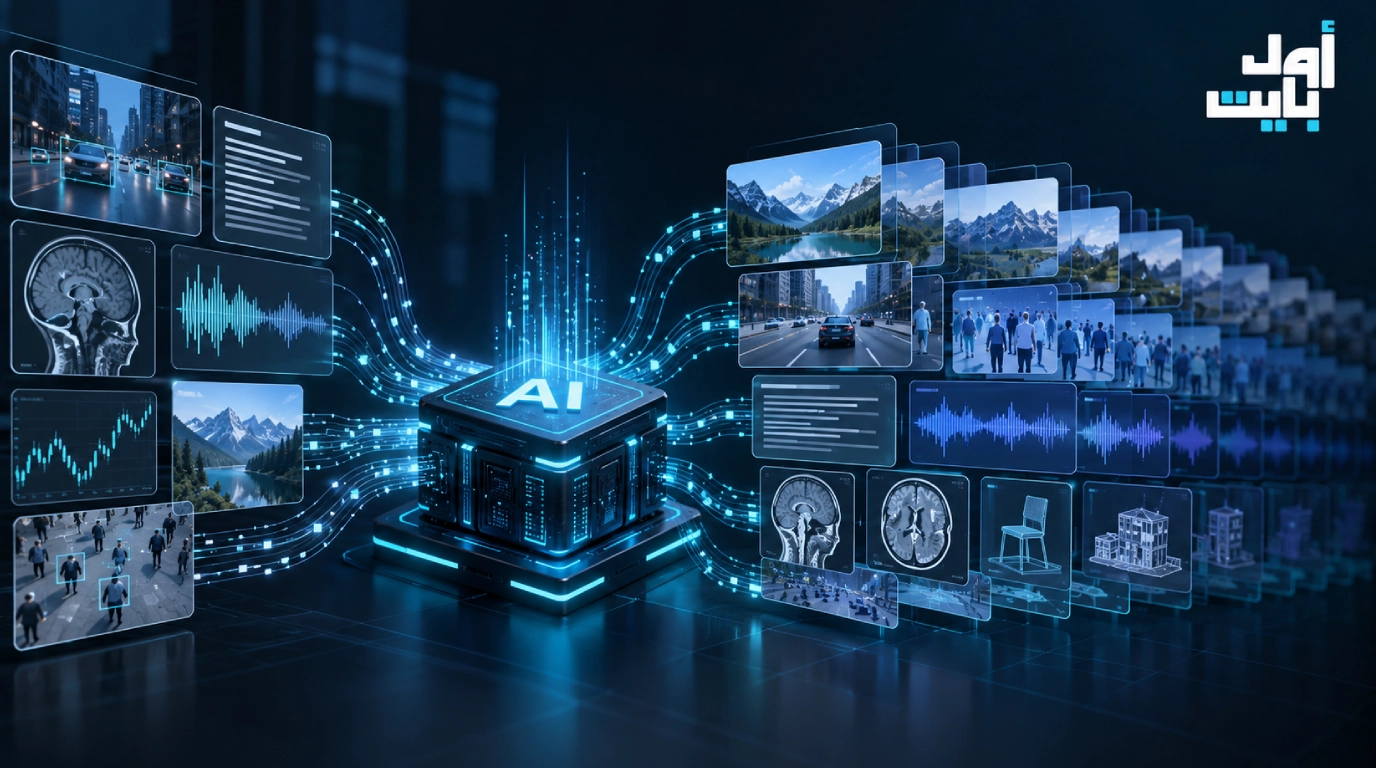
يحتاج الذكاء الاصطناعي إلى البيانات كي يتعلم. وكلما تطورت النماذج وازدادت أحجامها، ازدادت معها الحاجة إلى كميات ضخمة ومتنوعة وعالية الجودة من بيانات التدريب.
لكن ماذا يحدث عندما تصبح البيانات الحقيقية قليلة أو مكلفة أو حساسة أو يصعب جمعها؟
أحد الحلول هو أن نصنع بيانات جديدة.
تُعرف هذه البيانات باسم Synthetic Data أو البيانات الاصطناعية، وهي بيانات يتم إنشاؤها برمجيًا أو باستخدام نماذج ومحاكاة بدل الحصول عليها مباشرة من أحداث وأشخاص حقيقيين.
قد تكون نصوصًا أو صورًا أو أصواتًا أو سجلات مالية افتراضية أو مشاهد قيادة أو حالات طبية محاكية للواقع. ويمكن بعد ذلك استخدامها لتدريب نماذج ذكاء اصطناعي أخرى أو اختبارها وتحسين أدائها.
الفكرة تبدو بسيطة، لكنها تفتح سؤالًا أكبر: إذا أصبح الذكاء الاصطناعي يتدرب على بيانات أنشأها ذكاء اصطناعي آخر، فهل يمكن أن تستمر دورة التعلم هذه بلا حدود؟
ما هي البيانات الاصطناعية Synthetic Data؟
البيانات الاصطناعية هي بيانات يتم إنشاؤها بصورة مصطنعة بهدف محاكاة بعض الخصائص أو الأنماط الموجودة في البيانات الحقيقية.
بدل جمع مليون صورة حقيقية لسيناريو معين، يمكن مثلًا استخدام محاكاة أو نموذج توليدي لإنشاء صور تمثل السيناريو نفسه بتغييرات مختلفة.
وينطبق المبدأ على أنواع متعددة من البيانات:
- النصوص.
- الصور.
- الفيديو.
- الصوت.
- البيانات الجدولية.
- بيانات المستشعرات.
- سجلات المعاملات.
- البيئات ثلاثية الأبعاد.
ولا يعني وصف البيانات بأنها “اصطناعية” أنها عشوائية.
الهدف عادةً هو إنشاء بيانات تحمل خصائص تجعلها مفيدة لمهمة محددة، مثل تدريب نموذج على اكتشاف الأشياء أو الإجابة عن الأسئلة أو التعامل مع حالات نادرة.
وتعرّف IBM البيانات الاصطناعية بأنها معلومات مولدة اصطناعيًا تحاكي خصائص البيانات الواقعية ويمكن استخدامها في تطوير واختبار أنظمة الذكاء الاصطناعي وغيرها من التطبيقات.
لماذا يحتاج الذكاء الاصطناعي إلى بيانات اصطناعية؟
السبب الأول هو أن البيانات الحقيقية ليست موردًا غير محدود.
تدريب نماذج AI الحديثة يحتاج إلى كميات كبيرة من المعلومات، لكن الحصول على المزيد منها قد يصبح أصعب كلما توسعت النماذج.
هناك أيضًا مجالات لا يمكن فيها جمع البيانات بسهولة.
فإذا أردنا تدريب نظام قيادة ذاتية على التعامل مع حادث نادر، لا يمكن انتظار وقوع آلاف الحوادث الحقيقية لتسجيلها.
وإذا أردنا تطوير نموذج طبي، فقد تكون البيانات المطلوبة محمية بقيود خصوصية صارمة.
وفي المصانع قد يكون إحداث عطل حقيقي في آلة فقط لجمع بيانات عنه مكلفًا أو خطيرًا.
هنا يمكن إنشاء سيناريوهات مصطنعة تمثل الحالات المطلوبة ثم استخدامها أثناء التدريب أو الاختبار.
وبالتالي لا تستخدم Synthetic Data فقط بسبب نقص البيانات، بل لأنها تسمح أحيانًا بإنشاء البيانات التي نحتاج إليها تحديدًا.
كيف يتم إنشاء البيانات الاصطناعية؟
لا توجد طريقة واحدة.
أبسط الأساليب تعتمد على قواعد أو نماذج إحصائية تحدد شكل البيانات المطلوبة ثم تولد أمثلة جديدة وفق هذه القواعد.
لكن الذكاء الاصطناعي التوليدي وسّع الإمكانات بدرجة كبيرة.
يمكن اليوم استخدام نماذج توليدية لإنشاء:
- محادثات وأسئلة وأجوبة.
- صور لأجسام ومشاهد.
- أصوات اصطناعية.
- بيانات منظمة.
- أمثلة برمجية.
- سيناريوهات تدريب كاملة.
كما يمكن استخدام المحاكاة Simulation.
في السيارات ذاتية القيادة مثلًا، يمكن بناء مدينة افتراضية تحتوي على طرق وسيارات ومشاة وإشارات مرور، ثم تشغيل السيارة الافتراضية في آلاف السيناريوهات.
يستطيع النظام عندها الحصول على بيانات عن حالات يصعب أو يكون من الخطر اختبارها في العالم الحقيقي.
كيف تستخدم البيانات الاصطناعية لتدريب نماذج اللغة؟
لنفترض أن لدينا نموذجًا لغويًا قادرًا على إنشاء مسائل رياضية.
يمكن أن نطلب منه توليد آلاف المسائل بدرجات صعوبة مختلفة، ثم استخدام هذه المسائل لتدريب نموذج آخر.
لكن إنشاء السؤال وحده لا يكفي.
نحتاج عادةً إلى معرفة ما إذا كانت الإجابة صحيحة، ولهذا يمكن إضافة نظام تحقق أو نموذج أقوى أو قواعد محددة لتقييم النتائج.
قد تصبح الدورة مثلًا:
توليد سؤال → إنشاء إجابة → التحقق من الإجابة → الاحتفاظ بالأمثلة الجيدة → استخدامها في التدريب.
بهذه الطريقة يمكن توسيع بيانات التدريب دون الاعتماد بالكامل على نصوص كتبها البشر مسبقًا.
وقد أصبح توليد البيانات الاصطناعية جزءًا مهمًا من تطوير نماذج الذكاء الاصطناعي الحديثة، خصوصًا في مراحل التدريب اللاحقة وتحسين قدرات محددة مثل البرمجة والاستدلال.
هل الذكاء الاصطناعي يتعلم من ذكاء اصطناعي آخر؟
نعم، ويمكن أن يحدث ذلك بعدة طرق.
قد يولد نموذج قوي بيانات تستخدم لتدريب نموذج أصغر.
وقد يولد النموذج نفسه أمثلة جديدة ثم يتم اختيار أفضلها وإدخالها في دورة تدريب لاحقة.
كما يمكن استخدام عدة نماذج؛ أحدها يولد البيانات، وآخر ينتقدها أو يصنفها، ونظام ثالث يتحقق من النتائج.
لكن عبارة “AI يتعلم من AI” قد تكون مضللة إذا فهمناها على أنها عملية مستقلة تمامًا.
ما يزال البشر يحددون عادةً:
- الهدف من التدريب.
- بنية النظام.
- البيانات الأصلية.
- معايير الجودة.
- طرق التقييم.
- الخوارزميات المستخدمة.
- ما الذي يتم الاحتفاظ به أو استبعاده.
إذًا، توليد البيانات قد يكون آليًا، لكن تصميم منظومة التعلم نفسها لا يصبح تلقائيًا بلا قيود.
ما الفرق بين البيانات الحقيقية والبيانات الاصطناعية؟
البيانات الحقيقية تأتي من العالم مباشرة.
صورة ملتقطة بكاميرا، أو قياس حرارة من مستشعر، أو عملية شراء حقيقية، أو نص كتبه إنسان؛ كلها أمثلة على Real Data.
أما Synthetic Data فتم إنشاؤها اصطناعيًا.
| البيانات الحقيقية | البيانات الاصطناعية |
| تأتي من أحداث أو مستخدمين حقيقيين | يتم توليدها برمجيًا |
| جمعها قد يكون مكلفًا | يمكن إنتاجها بكميات كبيرة |
| قد تحتوي معلومات شخصية | يمكن تصميمها لتقليل استخدام بيانات الأشخاص |
| الحالات النادرة قليلة بطبيعتها | يمكن توليد حالات نادرة عمدًا |
| تعكس تعقيدات الواقع | تعتمد جودتها على النموذج أو المحاكاة |
| يصعب التحكم بتوزيعها | يمكن التحكم بالسيناريوهات المراد توليدها |
لكن هذا لا يعني أن البيانات الاصطناعية أفضل دائمًا.
الواقع يحتوي على تفاصيل وفوضى وحالات غير متوقعة قد يفشل النموذج المولد في محاكاتها.
ولهذا يكون الجمع بين النوعين أكثر واقعية في كثير من التطبيقات.
ما استخدامات Synthetic Data؟
تستخدم البيانات الاصطناعية في مجالات متعددة تتجاوز نماذج اللغة.
السيارات ذاتية القيادة
تستطيع المحاكاة إنشاء سيناريوهات مثل المطر والضباب والازدحام والمشاة والحوادث وظروف الإضاءة المختلفة.
الميزة الأساسية هي إمكانية تكرار السيناريو وتغييره آلاف المرات دون تعريض أشخاص حقيقيين للخطر.
الروبوتات
يمكن تدريب الروبوت داخل بيئة افتراضية قبل تشغيله في العالم الحقيقي.
يتعلم النظام التعامل مع الأجسام والحركة والبيئة داخل المحاكاة، ثم تُنقل القدرات إلى الروبوت الفعلي.
الرؤية الحاسوبية
يمكن إنشاء صور تحمل تسميات دقيقة تلقائيًا.
فإذا أنشأ النظام المشهد نفسه، فإنه يعرف موقع السيارة أو الشخص أو الجسم الموجود فيه، ما يقلل جزءًا من تكلفة تعليم البيانات يدويًا.
القطاع المالي
يمكن إنشاء سجلات معاملات مصطنعة لاختبار أنظمة اكتشاف الاحتيال أو تطوير النماذج دون استخدام جميع بيانات العملاء الحقيقية.
الرعاية الصحية
يمكن إنشاء بيانات تحاكي خصائص مجموعات بيانات طبية بهدف البحث والتطوير مع محاولة تقليل التعرض المباشر لمعلومات المرضى.
لكن استخدام البيانات الاصطناعية لا يلغي تلقائيًا قضايا الخصوصية أو التنظيم، خصوصًا إذا تم توليدها من بيانات حقيقية حساسة.
هل البيانات الاصطناعية تحل مشكلة الخصوصية؟
يمكن أن تساعد، لكنها ليست حلًا سحريًا.
إذا استطاعت مؤسسة استخدام مجموعة بيانات اصطناعية بدل مشاركة سجلات أشخاص حقيقيين، فقد تقل مخاطر كشف معلومات شخصية مباشرة.
لكن مستوى الحماية يعتمد على طريقة إنشاء البيانات.
إذا حفظ النموذج المولد أجزاء من بيانات التدريب الأصلية ثم أعاد إنتاجها، فقد تبقى مخاطر تسرب المعلومات موجودة.
لذلك يجب اختبار البيانات الناتجة للتأكد من أنها لا تكشف سجلات أو أفرادًا من مجموعة البيانات الأصلية.
كما أن إخفاء الأسماء من البيانات الحقيقية يختلف عن إنشاء بيانات اصطناعية جديدة؛ فهما تقنيتان مختلفتان لمعالجة مشكلة الخصوصية.
ما أكبر ميزة للبيانات الاصطناعية؟
إحدى أقوى الميزات هي القدرة على التحكم بما نريد أن يتعلمه النموذج.
تخيل نظامًا للتعرف على السيارات لديه مليون صورة، لكن معظمها ملتقط نهارًا.
قد يكون أداء النموذج ممتازًا في النهار وضعيفًا ليلًا.
جمع مئات آلاف الصور الليلية الحقيقية يحتاج إلى وقت وتكلفة.
أما في بيئة اصطناعية فيمكن تغيير الإضاءة والطقس والموقع وزاوية الكاميرا وإنشاء مجموعة بيانات جديدة تركز تحديدًا على نقطة الضعف.
أي أن Synthetic Data لا تضيف كمية فقط، بل يمكن استخدامها لتعديل توزيع بيانات التدريب.
وهذه ميزة مهمة عند التعامل مع الحالات النادرة.
ما مخاطر البيانات الاصطناعية؟
المشكلة الأساسية هي أن النموذج الذي يولد البيانات ليس نسخة مثالية من الواقع.
إذا كانت لديه أخطاء أو انحيازات، يمكن أن تظهر هذه المشكلات في البيانات التي ينتجها.
ثم يتعلم النموذج الجديد منها.
تضخيم الأخطاء
إذا ولّد AI معلومات خاطئة وتم استخدامها في التدريب دون تحقق، فقد تتحول الأخطاء إلى جزء من بيانات النموذج الجديد.
ولهذا تحتاج البيانات الاصطناعية إلى عمليات فلترة وتقييم.
فقدان التنوع
قد يميل النموذج المولد إلى إنشاء أمثلة متشابهة أكثر من اللازم.
وهذا يجعل مجموعة البيانات تبدو كبيرة من حيث عدد العناصر، لكنها محدودة فعليًا من حيث التنوع.
تمثيل غير دقيق للواقع
يمكن لمحاكاة أن تكون ممتازة لكنها لن تمثل بالضرورة جميع التفاصيل الموجودة في العالم الحقيقي.
وهذه المشكلة معروفة خصوصًا عند نقل نموذج من بيئة Simulation إلى الواقع.
الانحياز
إذا كانت البيانات أو النموذج المستخدم في التوليد منحازًا، يمكن للبيانات الاصطناعية إعادة إنتاج هذا الانحياز أو تضخيمه.
لهذا لا يمكن تقييم جودة Synthetic Data من شكلها فقط؛ بل يجب قياس ما إذا كانت تساعد النموذج فعلًا على الأداء الصحيح في بيانات حقيقية لم يرها أثناء التدريب.
ما هو Model Collapse؟
يظهر هنا أحد أكثر المخاوف إثارة للاهتمام في عصر الذكاء الاصطناعي التوليدي.
إذا أصبحت الإنترنت مليئة بالمحتوى الذي أنشأته نماذج AI، ثم استخدمت أجيال جديدة من النماذج هذا المحتوى لتدريب نفسها، فماذا يحدث؟
تبحث دراسات في ظاهرة تعرف باسم Model Collapse أو انهيار النموذج.
الفكرة هي أن التدريب المتكرر على بيانات مولدة يمكن، في ظروف معينة، أن يؤدي إلى فقدان أجزاء من توزيع البيانات الأصلية وتدهور النموذج عبر الأجيال.
أظهرت دراسة منشورة في Nature عام 2024 أن الاستخدام المتكرر غير المنضبط للبيانات المولدة في تدريب الأجيال اللاحقة يمكن أن يؤدي إلى انهيار النموذج وفقدان معلومات عن التوزيع الحقيقي للبيانات.
لكن النتيجة لا تعني أن استخدام Synthetic Data سيئ بحد ذاته.
المشكلة في الاعتماد غير المدروس على البيانات الاصطناعية بدل الحفاظ على بيانات حقيقية عالية الجودة وآليات تقييم مناسبة.
هل يمكن أن تنفد بيانات تدريب الذكاء الاصطناعي؟
من الأدق القول إن بعض أنواع البيانات البشرية عالية الجودة قد تصبح موردًا أكثر ندرة بالنسبة إلى حجم النماذج والطلب المتزايد، وليس أن الإنترنت سيصبح فارغًا من البيانات.
كما أن الحجم وحده ليس المشكلة.
النموذج يحتاج إلى:
- بيانات صحيحة.
- تنوع.
- تخصصات مختلفة.
- أمثلة صعبة.
- بيانات حديثة.
- إشارات تعلم مفيدة.
وقد تحتوي الإنترنت على تريليونات الكلمات، لكن ذلك لا يعني أن كل كلمة مناسبة لتدريب نموذج أفضل.
لذلك أصبحت الصناعة تبحث عن طرق للحصول على قيمة تدريبية أكبر من البيانات بدل التركيز فقط على جمع أكبر عدد ممكن من النصوص.
وهنا تدخل البيانات الاصطناعية كأحد الأدوات، إلى جانب تحسين جودة البيانات والتعلم المعزز والتقييم البشري وأساليب التدريب الأخرى.
هل ستستبدل البيانات الاصطناعية بيانات البشر؟
من غير المرجح أن يحدث ذلك بالكامل.
البيانات الحقيقية هي ما يربط النموذج بالعالم.
إذا أردنا أن يتعلم AI اللغة البشرية، فنحن بحاجة إلى أمثلة حقيقية عن كيفية استخدام البشر للغة.
وإذا أردنا نظامًا يفهم الطرق، فنحتاج في النهاية إلى بيانات من طرق حقيقية.
لكن البيانات الاصطناعية تستطيع ملء الفراغات وتوسيع مجموعات التدريب وإنشاء الحالات النادرة وتوفير أمثلة يمكن التحكم بها بدقة.
لذلك النموذج الأكثر واقعية للمستقبل ليس:
Real Data أم Synthetic Data؟
بل:
كيف ندمج البيانات الحقيقية والاصطناعية للحصول على مجموعة تدريب أفضل؟
هل يمكن للذكاء الاصطناعي الاستمرار في صنع بيانات لتدريب نفسه؟
تقنيًا يمكن إنشاء حلقات تولد فيها النماذج بيانات جديدة باستمرار.
لكن إنتاج المزيد من البيانات لا يعني إنتاج المزيد من المعرفة.
إذا لم تدخل إلى الدورة معلومات صحيحة أو آليات تقييم قوية، يمكن للنظام أن يعيد تدوير أخطائه بدل اكتشاف شيء جديد.
وهذا هو الفرق بين توليد البيانات واكتساب معرفة جديدة عن العالم.
يمكن للنموذج إنشاء مليون مسألة رياضية، لكن إذا لم توجد طريقة للتحقق من الحلول، قد نحصل على مليون مثال يحتوي على أخطاء.
أما عندما توجد بيئة تسمح بالتحقق من النتيجة، تصبح البيانات الاصطناعية أقوى بكثير.
في البرمجة مثلًا يمكن تشغيل الكود واختباره.
وفي الرياضيات يمكن التحقق من بعض الإجابات آليًا.
وفي المحاكاة يمكن معرفة ما إذا نجح الوكيل في تحقيق الهدف.
ولهذا قد تصبح البيئات التي توفر إشارة تحقق واضحة من أهم مصادر البيانات الاصطناعية عالية الجودة.
هل البيانات الاصطناعية مستقبل تدريب الذكاء الاصطناعي؟
الأرجح أنها ستكون جزءًا أساسيًا منه، وليست البديل الوحيد للبيانات الحقيقية.
مع توسع استخدام AI، ستزداد الحاجة إلى بيانات متخصصة وحالات نادرة وبيئات تدريب يمكن التحكم بها.
Synthetic Data توفر طريقة لإنشاء هذه البيانات بسرعة وعلى نطاق كبير.
لكن نجاحها يعتمد على ثلاثة أمور: جودة المصدر، وجود آلية للتحقق، والحفاظ على ارتباط مستمر بالبيانات الحقيقية.
المفارقة أن الذكاء الاصطناعي أصبح قادرًا على المساعدة في إنتاج المادة التي يتعلم منها الذكاء الاصطناعي نفسه.
وهذا قد يجعل تطوير النماذج أسرع، لكنه يخلق أيضًا تحديًا جديدًا: عندما تصبح الآلة منتجًا للبيانات ومستهلكًا لها في الوقت نفسه، تصبح معرفة مصدر البيانات وجودتها ومدى ارتباطها بالواقع أكثر أهمية من مجرد امتلاك أكبر مجموعة تدريب ممكنة.