


ما هو Robot Foundation Model؟ وكيف تتعلم الروبوتات مهارات متعددة بنموذج واحد؟

اعتادت الروبوتات الصناعية أن تكون ممتازة في تنفيذ مهمة واحدة متكررة: التقاط قطعة من مكان محدد، أو لحام جزء من سيارة، أو نقل صندوق على مسار معروف.
لكن تغيير المهمة قد يتطلب إعادة برمجة الروبوت أو تدريبه من جديد.
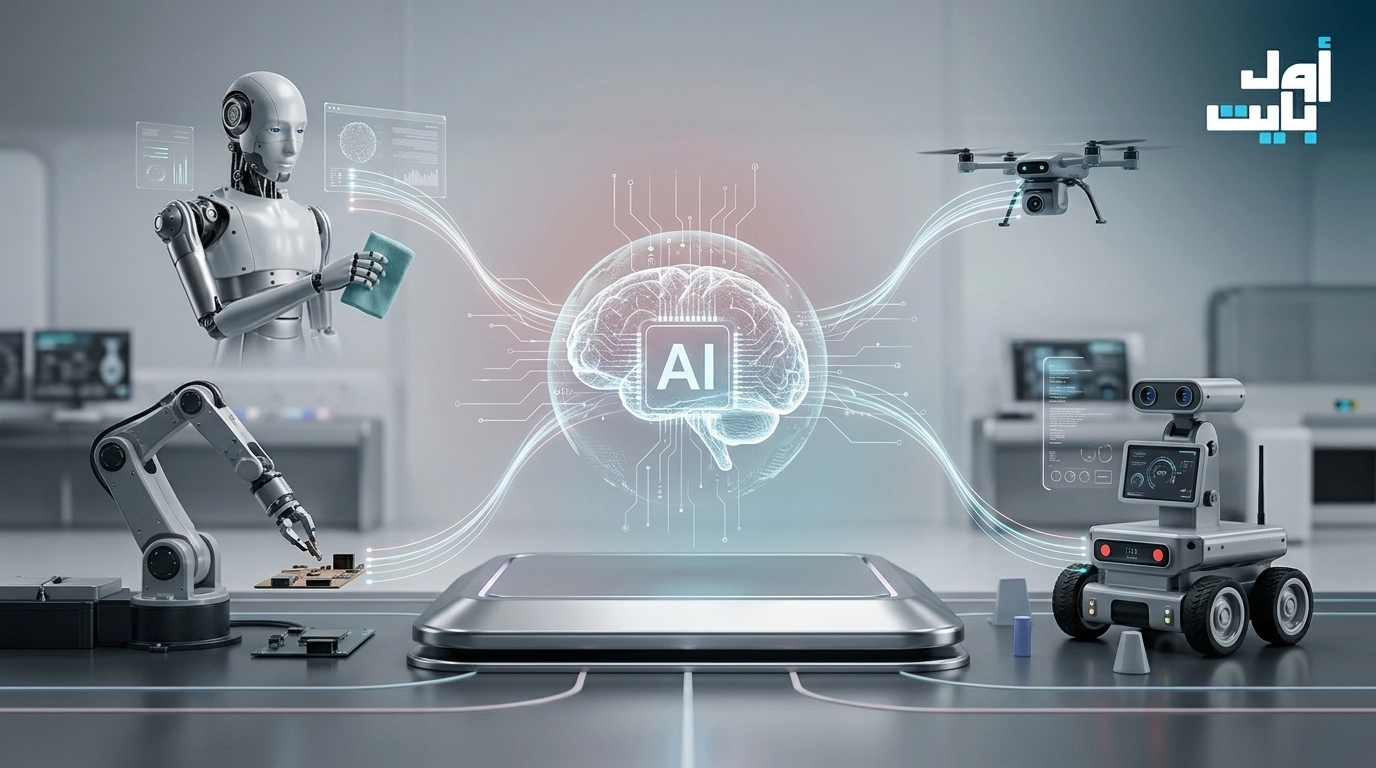
الجيل الجديد من الذكاء الاصطناعي يحاول تغيير هذه القاعدة من خلال Robot Foundation Models، وهي نماذج أساسية مصممة لمنح الروبوتات قدرات أكثر عمومية على فهم التعليمات ورؤية البيئة والتخطيط ثم تنفيذ الحركة.
وبدلاً من تطوير نظام ذكاء اصطناعي مستقل لكل مهمة، تسعى هذه النماذج إلى بناء «ذكاء أساسي» يستطيع تعلم عدد كبير من المهارات والتكيف مع روبوتات وبيئات مختلفة.
ما هو Robot Foundation Model؟
Robot Foundation Model هو نموذج ذكاء اصطناعي واسع التدريب مصمم لفهم العالم المادي ومساعدة الروبوت على تنفيذ مجموعة متنوعة من المهام.
الفكرة مستوحاة جزئياً من Foundation Models المستخدمة في الذكاء الاصطناعي التوليدي.
فالنموذج اللغوي الكبير لا يجري تدريبه لكتابة رسالة واحدة فقط، بل يتعلم أنماطاً عامة من كميات ضخمة من البيانات، ثم يستطيع استخدامها لتنفيذ مهام مختلفة.
تحاول Robotics Foundation Models نقل المبدأ نفسه إلى الروبوتات.
لكن المهمة هنا أصعب.
فالروبوت لا يتعامل مع النصوص والصور فقط، بل يجب أن يحول فهمه إلى حركة فعلية في العالم الحقيقي.
ما الفرق بين النموذج اللغوي ونموذج الروبوت؟
النموذج اللغوي يمكن أن يستقبل نصاً ويولد نصاً آخر.
أما نموذج الروبوت فقد يحتاج إلى التعامل مع الكاميرات والمستشعرات والتعليمات النصية أو الصوتية وحالة الروبوت وموقع الأشياء من حوله.
ثم يجب أن ينتج قراراً يمكن تحويله إلى حركة.
إذا طلبت من روبوت مثلاً:
«رتب الأشياء الموجودة على الطاولة.»
يحتاج النظام أولاً إلى معرفة الأشياء الموجودة أمامه.
ثم يفهم معنى «الترتيب»، ويحدد الأشياء التي يجب تحريكها، ويقرر ترتيب الخطوات، وبعد ذلك يوجه الذراع أو اليد الروبوتية للإمساك بكل عنصر ووضعه في المكان المناسب.
لهذا تحتاج نماذج الروبوتات إلى ربط الإدراك والاستدلال والحركة داخل منظومة واحدة.
ما هي نماذج Vision-Language-Action؟
واحدة من أهم التقنيات في هذا المجال هي Vision-Language-Action أو VLA.
الاسم يلخص الفكرة:
Vision: الروبوت يرى البيئة.
Language: يفهم التعليمات والمفاهيم.
Action: يحول هذا الفهم إلى أفعال وحركات.
بدلاً من أن ينتهي النموذج بإجابة نصية مثل روبوت المحادثة، يمكن أن يكون الخرج سلسلة أوامر تحكم تساعد الروبوت على تحريك ذراعه أو جسمه.
وقد أصبحت VLA من أهم المسارات المستخدمة لبناء Foundation Models للروبوتات.
في يوليو 2026 مثلاً قدمت Google DeepMind نموذج Gemini Robotics 2 بوصفه نموذج Vision-Language-Action يستطيع تحويل المدخلات البصرية واللغوية إلى تحكم حركي، بما في ذلك التحكم الكامل في أجسام روبوتات Humanoid.
كيف يتعلم Robot Foundation Model؟
يحتاج النموذج إلى بيانات توضح العلاقة بين ما يحدث في البيئة وما يجب على الروبوت فعله.
قد تأتي هذه البيانات من تشغيل روبوتات حقيقية وتسجيل الكاميرات والمستشعرات والحركات التي نفذها الروبوت.
ويمكن أيضاً جمع البيانات عندما يتحكم إنسان بالروبوت عن بعد، بحيث يتعلم النموذج من الطريقة التي نفذ بها الإنسان المهمة.
كما أصبحت المحاكاة مصدراً مهماً للبيانات.
يمكن تدريب الروبوت داخل بيئة افتراضية على آلاف أو ملايين السيناريوهات قبل نقله إلى العالم الحقيقي.
ويجري أيضاً استخدام الفيديو وبيانات متعددة الوسائط ومصادر أخرى تساعد النموذج على تكوين فهم أوسع للأشياء والحركة والعلاقات المكانية.
لماذا تحتاج الروبوتات إلى كميات ضخمة من البيانات؟
النماذج اللغوية تمتلك الإنترنت كمصدر هائل للنصوص والصور والفيديو.
الروبوتات لا تمتلك مورداً مكافئاً بالسهولة نفسها.
تسجيل ساعة من حركة روبوت حقيقي يتطلب أجهزة ومكاناً وطاقة وربما مشغلاً بشرياً، وقد تختلف البيانات بين روبوت وآخر بسبب اختلاف الأذرع والمفاصل والكاميرات.
وهذا يجعل Robot Data واحدة من أهم المشكلات التي تواجه الصناعة.
لذلك تحاول الشركات زيادة الاستفادة من المحاكاة والبيانات الاصطناعية، بالإضافة إلى تطوير طرق تسمح للنموذج بنقل ما تعلمه من روبوت إلى آخر.
هل يمكن لنموذج واحد التحكم بروبوتات مختلفة؟
هذه واحدة من أهم الأهداف الحالية.
إذا احتاج كل شكل من أشكال الروبوت إلى نموذج منفصل بالكامل، سيكون من الصعب بناء ذكاء روبوتي عام.
لذلك يجري العمل على Cross-Embodiment Learning، أي نقل المهارات والمعرفة بين أجسام روبوتية مختلفة.
قد يتعلم النموذج مفهوماً مثل الإمساك بجسم أو فتح باب، ثم يتكيف لتنفيذ الفكرة باستخدام ذراع روبوتية مختلفة.
وأعلنت Google DeepMind في 2026 أن Gemini Robotics 2 يستطيع التكيف مع أجسام روبوتية جديدة خلال ساعات، إضافة إلى تشغيل Humanoids وروبوتات ثنائية الذراع.
وهذا لا يعني أن أي نموذج يستطيع التحكم فوراً بأي روبوت، لكنه يوضح الاتجاه نحو فصل جزء من «الذكاء» عن شكل الجهاز الذي ينفذ الحركة.
ما الفرق بين Robot Foundation Models وPhysical AI؟
Physical AI هو المفهوم الأوسع.
يشير إلى أنظمة ذكاء اصطناعي تستطيع إدراك العالم المادي والتفاعل معه واتخاذ إجراءات داخله.
وتدخل تحت هذا المفهوم الروبوتات والمركبات الذاتية والآلات الصناعية وأنظمة أخرى.
أما Robot Foundation Model فهو أحد التقنيات المستخدمة لبناء هذا النوع من الذكاء داخل الروبوتات.
يمكن تبسيط العلاقة هكذا:
Physical AI = المجال الأوسع.
Robot Foundation Models = نماذج أساسية تساعد الروبوتات على اكتساب ذكاء أكثر عمومية.
VLA = إحدى البنى المستخدمة لتحويل الرؤية واللغة إلى أفعال.
ما علاقة World Models بالروبوتات؟
يمكن أن تحتاج الروبوتات إلى أكثر من معرفة «ما الذي أراه الآن؟».
عليها أيضاً توقع ما قد يحدث بعد تنفيذ حركة معينة.
إذا دفع الروبوت كوباً، أين سيتحرك؟
إذا أمسك جسماً مرناً، كيف سيتغير شكله؟
إذا سار في اتجاه معين، ماذا سيصبح أمامه بعد عدة خطوات؟
هنا تظهر أهمية World Models التي تحاول تمثيل كيفية تغير البيئة نتيجة الأفعال.
وجود نموذج يستطيع توقع نتائج الحركة يسمح للروبوت بالتخطيط قبل التنفيذ بدلاً من الاعتماد فقط على الاستجابة اللحظية.
ولهذا تتقاطع World Models وRobot Foundation Models ضمن الاتجاه الأوسع نحو Physical AI.
ماذا تغير في نماذج الروبوتات خلال 2026؟
أصبح الانتقال نحو نماذج أكثر عمومية واضحاً بصورة أكبر.
في يناير 2026 أطلقت NVIDIA نماذج وأدوات جديدة ضمن منظومة Physical AI، شملت عائلة GR00T لتعلم الروبوتات والاستدلال، بالتزامن مع عرض روبوتات جديدة من عدة شركات.
وفي أبريل قدمت Google DeepMind إصدار Gemini Robotics-ER 1.6 مع تحسينات في الاستدلال المكاني وفهم المشاهد من زوايا متعددة والتخطيط للمهام.
ثم في يوليو جاء Gemini Robotics 2 ليضيف التحكم الكامل في الجسم والمهارات الدقيقة وحتى التعاون بين عدة روبوتات.
وفي سبتمبر استمرت المنافسة على بناء ما يشبه «عقل الروبوت»، مع شركات تعمل على نماذج تستطيع فهم التعليمات وتنفيذ مهام متعددة في العالم الحقيقي.
لذلك لم يعد الاتجاه مقتصراً على بناء روبوت أفضل ميكانيكياً؛ هناك سباق موازٍ لبناء النموذج الذي يستطيع تشغيل الروبوت بذكاء أكبر.
هل تستطيع هذه النماذج جعل الروبوت يتعلم أي مهمة؟
ليس بعد.
ما تزال البيئة المادية أصعب بكثير من البيئة الرقمية.
قد يتغير الضوء أو مكان الأشياء أو الاحتكاك أو وزن الجسم، وقد يصادف الروبوت شيئاً لم يظهر في بيانات التدريب.
كما أن الخطأ في العالم الحقيقي له تكلفة.
إذا أخطأ نموذج لغوي في كلمة، يمكن تصحيحها.
أما إذا أخطأ روبوت يحمل جسماً ثقيلاً، فقد يؤدي ذلك إلى تلف المعدات أو إصابة شخص.
لذلك تحتاج النماذج إلى مستويات مرتفعة من الموثوقية والسلامة قبل منح الروبوت استقلالية واسعة.
هل ستصبح الروبوتات مثل ChatGPT؟
التشبيه مفيد لفهم الاتجاه، لكنه ليس دقيقاً بالكامل.
ما فعلته Foundation Models للبرمجيات هو توفير نموذج عام يمكن تكييفه لمجموعة ضخمة من المهام.
وتحاول شركات الروبوتات الوصول إلى شيء مشابه: نموذج عام يمكن تكييفه مع روبوتات ومهام متعددة.
لكن البيانات الفيزيائية أكثر تكلفة، وأجسام الروبوتات مختلفة، والسلامة أكثر حساسية.
لذلك سيكون الوصول إلى نموذج عام للروبوتات أصعب من بناء روبوت محادثة متعدد الاستخدامات.
لماذا تعد Robot Foundation Models مهمة لمستقبل الروبوتات؟
المشكلة الكبرى في الروبوتات لم تكن دائماً بناء المحرك أو الذراع أو الكاميرا.
المشكلة هي جعل الآلة تتعامل مع عالم لا يمكن توقع كل تفاصيله مسبقاً.
إذا نجحت Robot Foundation Models في منح الروبوتات قدرة أكبر على تعميم المهارات، فقد يتغير نموذج تطوير الروبوتات نفسه.
بدلاً من شراء آلة مصممة لمهمة واحدة، يمكن أن يصبح لدينا روبوت يمتلك مجموعة أساسية من القدرات، ثم يتعلم مهام إضافية باستخدام البيانات والتعليمات.
عندها يتحول السؤال من:
«ما المهمة التي بُرمج هذا الروبوت لتنفيذها؟»
إلى:
«ما المهارة الجديدة التي يمكن أن يتعلمها؟»
وهذا هو التحول الذي يجعل نماذج الروبوتات الأساسية واحدة من أهم حلقات الربط حالياً بين الذكاء الاصطناعي والروبوتات والعالم المادي.